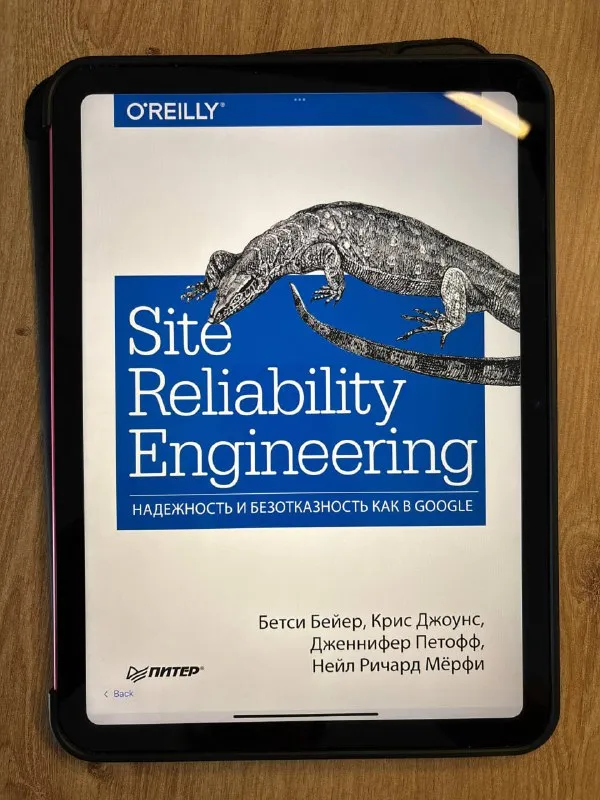
Одна из важнейших зон ответственности технического руководителя — обеспечение надёжности. Если вы сделали прекрасный, полезный для людей продукт, но ваши серверы лежат — считайте, что продукта нет.
Как технический руководитель, я регулярно обогащаю свои знания в области SRE (даже курс по администрированию кубера проходил). И, конечно, мне интересен опыт одной из крупнейших технологических компаний мира, работающей с колоссальными нагрузками и строгими требованиями к надёжности — Google.
О чём книга
Книга представляет собой сборник статей и транскрипций выступлений на тему надёжности от инженеров из Google. Для удобства читателя они разбиты на четыре раздела: введение в SRE, принципы, практики и управление.
В книге раскрываются следующие темы:
- Как организована работа SRE-команд в Google
- Процесс дежурств и всё, что с ними связано
- Как справляться с критическими ситуациями
- Почему SRE должны заниматься разработкой
- Как строить эффективные команды SRE
3 идеи из книги
-
“Скучность” ПО является его достоинством. Вряд ли кто-то захочет работать в среде, где программа может вести себя как попало. Чем более предсказуемы наши системы — тем лучше всем вокруг.
-
Упреждающий подход к авариям: SRE-инженеры в Google часто устраивают учебные сбои и ломают собственные системы, чтобы найти несовершенства в процессах мониторинга, алёртинга и устранения сбоев.
-
RPS — плохая метрика. Разные запросы имеют разные потребности в вычислительных ресурсах. Стоимость запроса может изменяться от целого ряда факторов. RPS однозначно стоит использовать для мониторинга нагрузки, но этот показатель не должен быть единственным.
Мои впечатления
Ощущения остались смешанные. Начну с плюсов: в книге есть много практик, которые актуальны и полезны до сих пор. В частности, могу выделить главы о том, как организовывать грамотный мониторинг, про процесс дежурств и про тестирование. Они более чем актуальны на сегодняшний день. Также очень хорош раздел про эффективное управление командами SRE и онбординг инженеров.
Но некоторые главы читать невыносимо скучно, а часть я вообще пропустил. В частности, тяжело читать главы про собственные решения Google, которые во многом применимы только у них — в голове постоянно приходится держать контекст и разбираться, что делает та или иная система.
Также нужно понимать, что книга старенькая, и многие рекомендации морально устарели. Тем не менее, она будет полезна руководителям, которые выстраивают процесс работы с надёжностью у себя в командах.
В целом, книга достаточно хороша, чтобы погрузиться в проблему построения надёжных, отказоустойчивых систем и организовать базовую работу команды SRE. Это скорее инженерная философия Google, чем учебник. Рекомендую читать главы выборочно — всё подряд читать не стоит.