Команда разработчиков на одном из моих проектов стремительно растёт. И вместе с ней растёт количество PR. Они объёмные, их много и читать их полностью уже становится физически тяжело. А другие проекты тоже никуда не делись и требуют внимания.
Для ревью такого объёма кода хочется выделить главное и внимательно проверять только его. Но что считать главным в коде?
Для себя я выделяю две вещи: понимание устройства системы другими людьми и поддержание архитектуры и чистоты кода. У автора изменения глаз замыливается. А в возможность долго развивать систему, не понимая, как она работает под капотом, я не верю.
Но это мой приоритет. Он ещё не доказывает, что нынешнее ревью действительно передаёт знания. Хочется верить, что люди изучают кодовую базу, пока читают PR. Понять, насколько хорошо это происходит, я пока не могу. Даже продолжительность ревью у меня сейчас - наблюдение, а не замер активного времени чтения.
В предыдущем ресёрче про код-ревью в эпоху ИИ я описал, как мой фокус уже сместился на спецификации, архитектуру, контракты и интеграционные тесты. Но вопрос остался: насколько такой подход сохраняет качество и передаёт знания команде? Теперь полез разбираться, что конкретно команды меняют в процессе, сколько стоит эта замена и какую полезную работу можно случайно выкинуть вместе с чтением кода.
Какую работу мы хотим сохранить
У человеческого ревью несколько функций: найти ошибки, улучшить код, согласовать решения, обменяться знаниями и контекстом. Исследование Bacchelli и Bird в Microsoft показывает эту разницу между ожиданиями и результатами. Главной заявленной мотивацией участников был поиск дефектов, но наблюдаемая польза им не ограничивалась. Оснований объявлять передачу знаний исторически главной целью любого ревью нет.
Для изменения процесса это существенная разница. Агент может найти ошибку, а соседний разработчик так и не узнает, как устроено изменение. Совместное обсуждение может согласовать архитектуру, но пропустить неверную проверку в тесте. Количество комментариев и наличие approval не отвечают сразу на все эти вопросы.
И универсального процесса, в котором люди читают меньше, а качество, согласование и командные знания доказанно сохраняются, в рассмотренных мною материалах не нашлось. Зато нашлись разные способы перераспределить работу, и их уже имеет смысл выбирать под конкретную потерю времени.
Если PR лежит сутки в очереди, это одна проблема. Если человек два часа восстанавливает контекст большого изменения - другая. Если полчаса разбирает замечания бота - третья. У меня пока наиболее заметно чтение больших PR. Поэтому начать хочется с того, чтобы раньше понимать замысел изменения.
Общий план до кода: можно попробовать
Honeycomb описывает близкую ситуацию: рост нагрузки на ревью и попытку перенести часть совместной работы в планирование. Команда стала вместе прорабатывать планы и промпты до реализации. Автор разбора отмечает, что общая осведомлённость стала лучше.
При этом статья описывает почти отказ от активной работы с кодом в пользу более пассивного и рискованного мониторинга. Я хочу проверить другой вариант: обсуждать спеку заранее, сохраняя ревью реализации. Раннее обсуждение должно дать ревьюеру контекст, чтобы замечать отклонения в коде, но непонятно, сработает ли это сочетание.
Но у Honeycomb это опыт одной команды, без надёжного сравнительного измерения знаний или скорости. Строгий процесс оказался тяжёлым, и его используют выборочно. В том же рассказе есть неприятная оборотная сторона: тесты, которые трудно сопровождать без помощи ИИ. Люди могут лучше знать, что команда собиралась сделать, и при этом плохо владеть получившимся кодом.
Первая моя идея эксперимента заключается в том, чтобы попробовать ревью плана и сценариев в SDD, spec-driven development: сначала ревьюим всю спеку задачи, потом код.
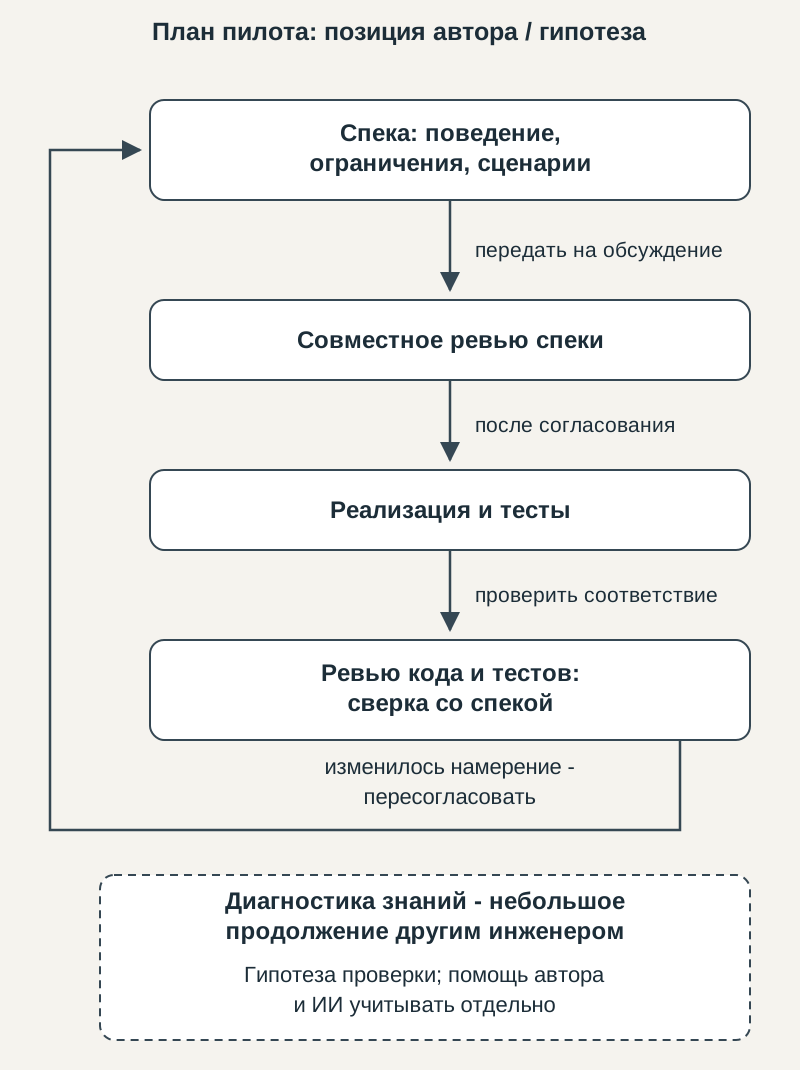
Идея эксперимента: согласование спеки до реализации, сохранение ревью кода и тестов, отдельная диагностика знаний
Рабочая гипотеза: на неоднозначной задаче, особенно затрагивающей несколько модулей, раннее обсуждение ограничений уменьшит объём решений, которые придётся восстанавливать по готовому PR. Ссылки на код помогут сверить объяснение с реализацией. Проверять это стоит по переделкам и полному времени участников.
Здесь легко завести ещё один ритуал. Если написать документ, провести встречу, а затем всё равно заново разбираться с теми же вопросами в коде, разгрузки не получится. Если объяснение расходится с реализацией, то оно добавляет ложную уверенность. Поэтому для первого опыта достаточно одной подходящей задачи и одного общего описания, а не нового обязательного пакета документов на каждый PR.
Что именно даёт спека
У спеки есть понятная роль: зафиксировать ожидаемое поведение и ограничения, о которых договорились люди. Дальше остаётся проверить, соответствует ли им реализация, и пересогласовать отклонения.
В небольшом авторском опыте Garg доступ к спеке и документам дизайна увеличил время ревью без значимого выигрыша в поиске отклонений. Замечания чаще привязывали к именованным требованиям, доступным этой группе. Но выборка маленькая – пять ревьюеров и две реализации.
У Google есть измеренный выигрыш контрактной стадии в другой задаче: автоматическая генерация тестов стала лучше обнаруживать исторические баги в режиме до пяти попыток. При одной попытке значимого различия не нашли. Спецификации извлекали из уже исправленного кода, люди в процессе не участвовали, а расход токенов вырос.
И даже правильно выраженное ожидание ещё нужно превратить в проверку, которая действительно ловит нарушение. Общая ошибка может оказаться сразу в спеке, реализации и тестах. Их согласованность тогда мало утешает.
Поэтому для моего эксперимента вопрос звучит так: стало ли проще понять решение и проверить его реализацию? Скольких переделок удалось избежать? Сколько времени ушло на поддержку самого описания? Если спека перестаёт соответствовать коду, её объём и процесс обновления придётся пересмотреть.
Оснований заменять чтение кода чтением документа я в этих данных не вижу.
Агент перед человеком: можно попробовать, но считать разбор замечаний
Предварительная проверка агентом - ещё одна практика, которую я готов пробовать. Агент смотрит изменение до человека, автор разбирает замечания, и до ревьюера доходит подготовленный PR. Это попытка снять часть поиска проблем, сохранив человеческую проверку решения.
Но полезные замечания сами по себе ещё не означают экономии времени. В локальном A/B-эксперименте Google с AutoCommenter, системой проверки coding practices, не обнаружили значимого изменения общей длительности ревью, активного времени и числа итераций. Этот опыт относится к системе, использовавшейся с 2023 года, и не задаёт потолок нынешним инструментам.
Положительные результаты тоже есть. В препринте исследователей Ericsson авторы-коммитеры оценили почти все выданные замечания как корректные. Но! проверяли всего семь Python-коммитов.
Агент не обязательно будет шумным и бесполезным. Но доля корректных комментариев сама по себе не обещает разгрузки.
Гипотеза небольшого пилота: выбрать один класс изменений, проверить агента на исторических ошибках и PR без известных дефектов, затем запустить предварительную проверку без права самостоятельно разрешать merge. Считать подтверждённые находки и всё человеческое время: разбор замечаний, исправления, повторные циклы и последующее ревью.
Если агент экономит чтение, но заставляет столько же времени спорить с ним или чинить его советы, выгоды это решение не даёт. Сохранение командных знаний такой пилот тоже не проверяет: неизвестно, станет ли другой инженер лучше понимать изменение.
Убирать approvals по риску: только в узких условиях
Команда Claude Code описывает процесс, где число обязательных человеческих approvals зависит от риска: ноль, один или два. Это действует для доверенных авторов, с исключениями, в процессе из нескольких слоёв проверки, CI и выпуска.
По их сообщению, с июня по сентябрь число смерженных PR выросло более чем вдвое, а доля откатов снизилась более чем на 40%. Выглядит хорошо. Но менялся весь процесс, поэтому приписать результат снятию approvals нельзя. Доля откатов также не охватывает все дефекты.
Есть и другой публичный вариант. Stripe сообщает о более чем 1300 смерженных PR в неделю с полностью агентской реализацией и сохранённым человеческим ревью. Глубина чтения и сравнительное качество из этого рассказа неизвестны. Но он показывает, что агентская разработка не требует обязательного отказа от человеческого допуска.
Для эксперимента с approvals нужны узкая категория изменений, ответственный владелец, ограниченные последствия, наблюдаемость и проверенный способ восстановления.
Гипотеза первого шага: пока сохранить прежний допуск и проверить, какие реальные PR команда отнесла бы к категории без обязательного approval. Ошибки такой классификации можно обнаруживать до снятия проверки. Если она пропускает опасные изменения, оснований двигаться дальше нет.
Копировать число approvals без окружающего процесса из этого кейса не следует. И двигаться к нулю как к обязательной конечной точке тоже незачем.
Внешние сценарии: выглядит интересно, но данных для замены мало
StrongDM описывает software factory, где вместо человеческого чтения кода используются спецификации, внешние сценарии, цифровые двойники зависимостей и оценивание с помощью LLM. Здесь меняют сам способ проверки результата.
Идея мне интересна для небольших некритичных изменений. Но публичное описание процесса ещё не показывает его сравнительную безопасность или полную стоимость. Что происходит с командными знаниями, тоже неизвестно.
Сценарии могут не покрывать нужное поведение. Двойник внешнего сервиса может расходиться с реальным API. Оценщик может принять плохую реализацию. Поддержка всей этой конструкции - отдельная работа, которую нельзя просто так взять и вычеркнуть из цены.
Поэтому общий вердикт по замене ревью - пока наблюдать. Если механизм внешней проверки уже есть, можно сформулировать более узкую гипотезу эксперимента: проверить его на заведомо плохих реализациях, сохраняя прежний порядок допуска. Это позволит увидеть часть слепых зон. Строить целую фабрику ради пока не измеренной экономии нескольких минут чтения оснований нет.
Например, я бы попробовал отдать на такое ревью рефакторинг или обновление пакетов. Ещё можно поэкспериментировать со всякими бэкоффисами, которые почти в любом проекте есть – обычно там есть некритичный функционал.
С тестами моя первоначальная идея не сработала
Одна из моих исходных гипотез была такой: реализацию тестов можно не читать, достаточно смотреть по тест кейсам, что именно проверяем. Основное внимание в таком ревью уходит на домен, архитектуру и спеку.
Увы, всё не так радужно. Агент может написать корявые, но проходящие тесты. Возможно, тесты читать даже важнее, чем код.
У кейса и его реализации разные способы ошибиться. Описание обещает проверить нужную ситуацию, но входные данные её не создают. Мок прячет поведение, ради которого затевалась проверка. Assertion не проверяет заявленное свойство. Спека, код и тест могут одинаково не учитывать один случай.
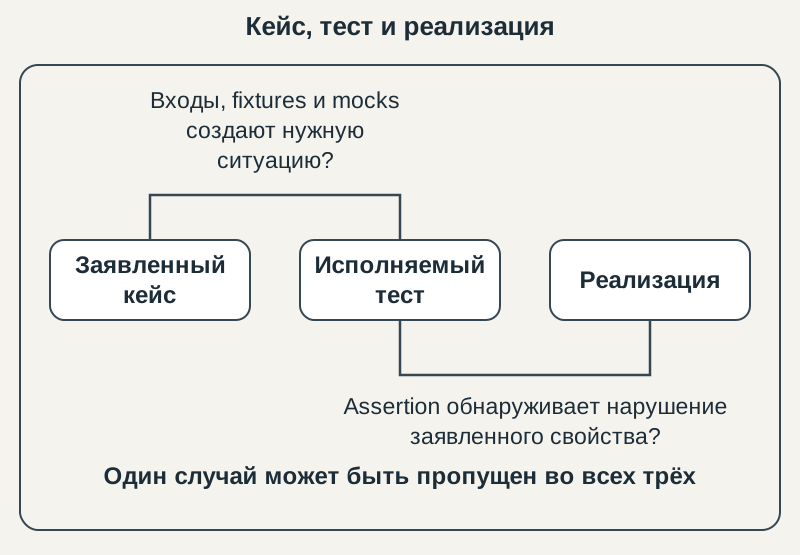
Отдельные вопросы проверки: создают ли входы, fixtures и mocks нужную ситуацию и обнаруживает ли assertion нарушение заявленного свойства.
Прямого подтверждения, что чтение только кейсов равноценно чтению реализации постоянных тестов, в рассмотренных материалах нет. В эксперименте Spadini и коллег чтение тестов первыми помогало находить ошибки в самих тестах, но ухудшало поиск проблем сопровождаемости production-кода. Значимого различия в поиске production-багов не нашли.
Соседняя практика есть у Meta: генерировать временные catching-тесты, которые помогают обнаруживать смену поведения до и после изменения. Команда фильтрует кандидатов и отдельно разбирается, ожидаема ли найденная разница. Это промышленный опыт с полезными находками, но калибровка включает чтение тестового кода и трассировок. Из него не следует разрешение перестать читать постоянный набор тестов.
Для разгрузки своего ревью я бы не начинал с отказа от чтения реализации тестов. Согласованный список кейсов оставляет слишком большой вопрос: проверяет ли исполняемый код то, что мы только что одобрили?
Самый неприятный риск проявится позже
Даже если ревью ускорилось и дефектов пока не видно, остаётся мой исходный вопрос: кто теперь понимает систему?
У Honeycomb лучшая общая осведомлённость соседствует с трудностями сопровождения тестов без ИИ. Есть и смежный эксперимент Anthropic: участники, осваивавшие незнакомую библиотеку с ИИ, хуже справились с немедленной проверкой навыков. Однако в основном это были junior-инженеры.
Но риск стоит проверять отдельно. Понятное объяснение и способность самостоятельно продолжить работу - разные результаты.
Гипотеза проверки: другой инженер объясняет ограничения и причины решения, затем делает небольшое продолжение. Время, ошибки и помощь автора или ИИ учитываются отдельно. Такая диагностика не доказывает долгосрочного сохранения знаний, но может обнаружить, что за понятным документом никто не разобрался с реализацией.
Если поддерживать изменение способен только его автор вместе с агентом, повод вернуть совместное чтение уже есть. Правда, и полезность самого прежнего ревью нужно проверять: наличие второго approval не гарантирует, что раньше было лучше.
Как проверить, стало ли легче
Рабочая гипотеза проверки процесса: взять сопоставимые задачи и менять по одной практике, чтобы хотя бы понимать, с чем связан наблюдаемый результат.
Смотреть придётся на несколько вещей:
- Скорость: сколько задача ждёт действий и сколько люди активно работают с ней.
- Полную цену: чтение, обсуждения, разбор замечаний, исправления, поддержка документов и автоматизации, восстановление после merge.
- Качество: дефекты после merge с учётом тяжести и объёма изменений, откаты и инциденты.
- Сопровождаемость и знания: насколько трудно другому инженеру понять результат и сделать следующее изменение.
Условия остановки тоже нужны заранее. Вредные советы агента и лишний разбор - это повод сузить предварительную проверку. Устаревающая спека - повод упростить документ и процесс его поддержки. При ошибках в оценке риска нужен прежний обязательный допуск. Если люди теряют способность сопровождать код, придётся вернуть человеческое чтение или парную работу для этого класса изменений.
Короткий пилот без инцидентов не докажет безопасность редких событий. А время, сэкономленное на ревью и потраченное на следующей задаче, всё равно придётся заплатить.
Спецификации я уже использую в ревью. Следующий шаг хочу попробовать на одной задаче: совместно разобрать замысел до реализации, чтобы потом меньше восстанавливать его по готовому PR. Ревью кода и тестов пока сохраняю.
От идеи читать только тест-кейсы я отказываюсь: по описанию нельзя понять, проверяет ли тест обещанное. Снимать обязательные approvals пока тоже не вижу оснований.