Изменения в процессе ревью я остро ощущаю на себе прямо сейчас. Самих PR-ов стало больше и они стали гораздо длиннее, потому что LLM позволяет сразу писать кучу тестов, обновлять документацию и делать ещё много вспомогательной работы. Это накладывает свой отпечаток на мою работу: приходится ревьюить гораздо больше кода и качество этого процесса постепенно снижается с усталостью. Каждый последующий аппрув я ставлю с меньшей уверенностью.
С публичными данными о ревью в индустрии есть две сложности. Значительная часть телеметрии приходит от продавцов инструментов. А исследование CMU 2026 года показало, что тренды «агентские PR реже ревьюят, быстрее мёржат, меньше обсуждают» могут переворачиваться при другой, столь же правомерной сборке GitHub-данных. Поэтому цифры ниже описывают конкретные выборки. Переносить их на свою команду и объяснять ими причины изменений нужно осторожно.
Поток ревью вырос и получил машинный первый круг
Исследование роллаута агентских CLI в Microsoft1 зафиксировало рост числа смёрженных PR у подключившихся инженеров на 24%. Это измерение одного работодателя, но оно согласуется с моим наблюдением: изменений становится больше, и все они попадают в чей-то процесс проверки.
Copilot code review стал общедоступным в апреле 20252. В марте 2026 Anthropic выпустила собственный Code Review3, объясняя запуск тем, что ревью стало бутылочным горлышком. Машинный первый круг уже доступен в основных инструментах разработки.
На текущий момент все PR, которые проходят через меня, написаны агентом под контролем человека. Один разработчик спокойно делает порядка 7-10 PR в неделю, но они довольно большие и на ревью «по-старому» уходит много времени. Поэтому, чтобы успевать за темпом разработки и не становиться бутылочным горлышком, мне приходится ревьюить только часть изменений - архитектуру, миграции, контракты, изменения в домене и так далее.
Подпись осталась человеку
Политика GCC требует, чтобы вклад вносил человек, который понимает изменения и готов отвечать на вопросы о них. Решение о включении в проект тоже принимает человек; Signed-off-by ставит только человек, а использование LLM помечается тегом Assisted-by:.
Формально агент может написать код, но ответственность за принятое изменение остаётся у человека. Подпись сама по себе ещё не говорит, насколько тщательно он его проверил.
На нас давят сроки и обязательства, а объём кода на ревью растёт. Поэтому мы используем SDD на базе OpenSpec, чтобы проверять, реализует ли написанный код нужную нам бизнес-логику. Не гарантия, но работу облегчает значительно.
У этого подхода тоже есть цена. В сентябрьском пилоте «When Spec-Driven Development Pays Off» пять ревьюеров проверяли два сгенерированных банковских сервиса со спецификацией и без неё. Значимого улучшения обнаружения расхождений не нашли: 52,5% против 51,8%. Со спецификацией замечания чаще привязывали к конкретному требованию, но ревью занимало в среднем 48,4 минуты вместо 26,7. Пять человек и один домен - слишком мало для общего вывода; это повод различать проверку соответствия требованиям и способность найти больше ошибок.
В работе «Where Accountability Lives»4 авторы разобрали 121 артефакт: документацию инструментов, платформенные контролы и политики провайдеров. Платформы записывают события, условия использования возлагают обязанность проверить код, но запись об исполнении этой обязанности часто отсутствует. В регулируемых средах этот зазор может закрываться обязательными процедурами approvals.
GitHub в июле 20255 обещала, что кнопка мерджа останется у человека. Но документация Copilot code review уже допускает зачёт ревью агента в required approvals6: опциональная возможность в public preview, по умолчанию выключенная. Обязательное человеческое ревью уже нельзя считать технически неизменным правилом.
Предел человеческой проверки хорошо виден на примере curl, когда летом 2026 проект на месяц перестал принимать vulnerability-репорты7 после потока AI-сгенерированных отчётов. Это другой процесс, но ограничение знакомое: разбирать входящий поток должны люди, и их внимание не растёт вместе с ним.
Мне и моим ребятам пока неплохо удаётся разгребать очередь, но периодически ревью застревают из-за человеческого фактора (например, недавно я два дня не вылезал из созвонов и всё это время задачи дожидались меня). Как я и писал в ресёрче про изменения в SDLC, ревью стал одним из самых ощутимых бутылочных горлышек.
Что машинный первый круг действительно снимает с человека
Один из самых изученных кейсов - Google. AutoCommenter8, LLM-ревьюер практик кодирования, ежедневно используют десятки тысяч разработчиков. Около 40% его комментариев приводят к изменению кода. Но собственный A/B Google не показал значимых изменений ни в длительности ревью, ни в числе итераций. Польза отдельных замечаний есть; освобождение времени ревьюера этим экспериментом не подтверждено.
Stripe сообщает9 о более чем тысяче агентских PR в неделю, которые проходят человеческое ревью. Это объём всей компании; по нему нельзя посчитать нагрузку отдельного ревьюера или время, которое он тратит на PR.
У других AI-ревьюеров результат тоже зависит от того, что именно считать пользой:
-
RevMate10 - полевой эксперимент в Mozilla и Ubisoft: к публикации приняли около 8% комментариев LLM-ревьюера. Но принятые AI-комментарии приводят к правкам кода так же часто, как человеческие, то есть acceptance - плохая метрика пользы.
-
Конфигурация ревьюера с фокусом на дефектах находила главные баги вдвое лучше стандартных LLM11; авторы исследования связаны с индустрией.
-
Полевое исследование на материале более чем 22 000 комментариев в 178 репозиториях: даже непринятые замечания вызывают рефлексию и влияют на будущие правки12.
Мне пока не удалось полноценно пощупать AI-ревью на практике. На предыдущей работе оно было внедрено, но его полезность была весьма и весьма условной (агент только мелочи всякие находил). Тем не менее я вижу, что индустрия двигается в этом направлении, и планирую вернуться к теме внедрения AI-ревью, как только появятся силы и время.
Даже с машинным первым кругом остаётся вопрос, как меняется человеческая проверка. Публичные следы ревью позволяют проследить поведение, но не всегда объясняют его причины.
Что люди делают на ревью
«Habituation at the Gate» прослеживает одних и тех же ревьюеров на открытом датасете AIDev: несколько сотен человек, больше десяти тысяч ревью, семь месяцев наблюдения. При сравнении поведения одних и тех же ревьюеров в разные периоды доля одобренных агентских PR растёт, а доля одобренных человеческих падает; одновременно снижается доля инлайн-комментариев и растёт время ожидания ревью. Авторы считают данные наиболее совместимыми с привыканием. Это воркшоп-статья на open-source данных; дефекты за аппрувами она не измеряет13.
Здесь пришла пора покаяться: я не ревьюю агентские PR так же тщательно, как раньше ревьюил человеческие. Я читаю его менее внимательно и оставляю меньше комментариев, потому что качественно вычитывать такой объём кода сложно. Не могу сказать, что горжусь этим поведением - скорее я воспринял его как знак, что пришла пора что-то менять в подходе. Отчасти из описанной проблемы и родился этот ресёрч.
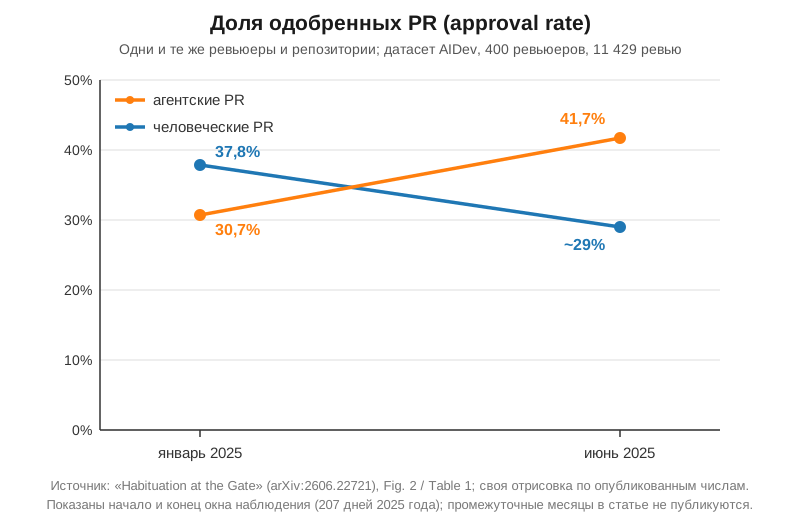
На графике только начало и конец окна наблюдения (207 дней 2025 года). Промежуточные помесячные значения в статье не публикуются, «~29%» - приближение авторов. Это одна аналитическая сборка открытого датасета AIDev; после июня в человеческой ветке осталось 207 наблюдений. Источник: «Habituation at the Gate» (arXiv:2606.22721), Fig. 2 и Table 1. График построен по опубликованным числам.
У этой динамики есть альтернативные объяснения: агенты могли улучшиться, задачи - стать проще, а контроль - переехать в другие этапы. Например, в исследовании 567 агентских PR14 45% принятых изменений потребовали дополнительных правок. Более частый аппрув сам по себе не доказывает, что человек перестал проверять код.
Поведение ревьюеров меняется. Но выбрать между привыканием, перекалибровкой под улучшившихся агентов и переносом проверки в другие каналы эти данные не позволяют. Исследование динамики approval не связывает её с последующими дефектами.
Где живут ошибки агентского кода
Чтобы понять, что приходится проверять человеку, полезно посмотреть на профиль ошибок. В отчёте Veracode15 более чем на 100 моделях сгенерированный код почти всегда проходит синтаксические проверки, но безопасность - в среднем в 56% случаев, у лучшей модели в 68%. Без security-ориентированного промпта модели фейлят примерно 44% задач. Разрыв между синтаксисом и безопасностью сохраняется два года.
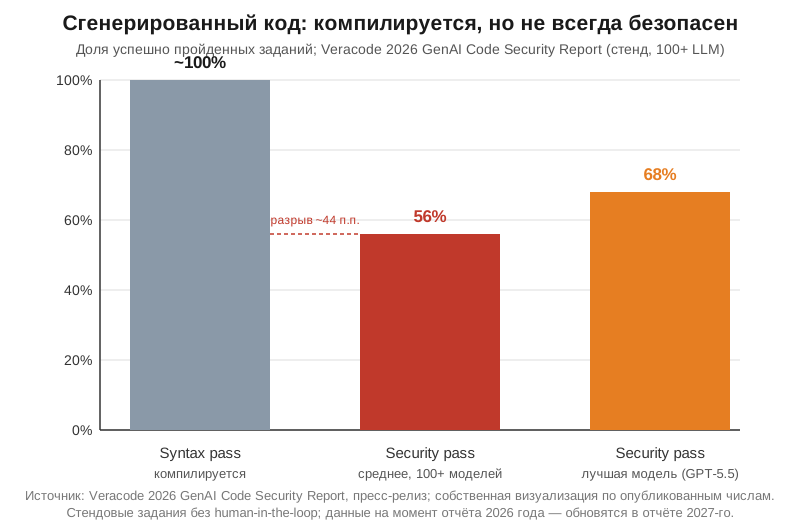
Данные получены на синтетических заданиях по безопасности без участия человека в проверке кода. Veracode продаёт инструменты защиты, поэтому это вендорские данные. Цифры относятся к отчёту 2026 года. Источник: Veracode 2026 GenAI Code Security Report. График построен по опубликованным числам.
В реальных репозиториях работают дополнительные барьеры: исследование выживания AI-внесённых проблем16 показало, что до свежих ревизий доживает 22,7% отслеженных проблем. Остальные исчезают по мере тестов, ревью и правок; вклад каждого слоя отдельно работа не выделяет.
Измерения после мерджа уже появляются. В сентябрьской работе «Who Finishes the Job?» в общем окне наблюдения подтверждённые исправления в течение 30 дней получили 3,68% агентских PR против 2,34% человеческих. Это последующие фиксы, а не статистика инцидентов в продакшне. Связи размечала LLM с проверкой на человеческих примерах; метод пропускает часть исправлений. Разницу нельзя приписать именно слабому ревью.
И результат неодинаков для разных агентов. В препринте «Not All Agents Are Equal»17 на 37 623 PR откаты за 90 дней встречались у Codex реже, чем у людей, а у Devin чаще. Выборки относятся к задачам и агентам 2024-2025 годов, задачи не распределяли случайно. Это ограничивает выводы о нынешних продуктах, но уже не позволяет описывать весь агентский код одним профилем качества.
Как я уже упоминал, я не читаю сгенерированный код строка за строкой. Теперь вместо этого я читаю в первую очередь спецификации, ADR и контракты. Также обращаю внимание на изменения в интеграциях с другими системами, БД/домене и миграции. Ещё я довольно внимательно изучаю интеграционные тесты, чтобы понять логику работы и убедиться, что она верна.
Очередь против глубины
Смысловая проверка дорога по времени. При растущем потоке приходится искать, как сохранить её глубину и успеть за разработкой. Но рост очереди сам по себе ещё не означает ухудшения качества.
В августовской работе «Characterizing the Quality Profile of AI-Generated C++ in Production»18 авторы из Google изучили 3,52 млн изменений одного крупного работодателя. В описательном сравнении у AI-кода было в 1,92 раза больше обсуждений, которые требовалось закрыть перед мерджем, и в 1,19 раза больше времени до мерджа, но медианное отношение частоты откатов AI-кода к частоте откатов человеческого кода составляло около 0,9. Зато быстрее росли затраты вычислительных ресурсов и памяти. Это наблюдательный препринт об одном C++-конвейере: он не выделяет эффект ревью, но показывает, что дополнительная работа до мерджа может сосуществовать с меньшей частотой откатов.
Есть и описанные командами контрпримеры: Honeycomb19 углубила ревью агентского кода и планов, сохранив velocity. А исследование Queen’s University на 1,02 млн PR20 показывает более сложный результат: некоторые схемы с агентами ускоряют принятие решения, но чаще сопровождаются проблемами в организации ревью. Что это означает для дефектов в продакшне, работа не измеряет.
Моя гипотеза: при большом потоке агентских PR проверка может превращаться в формальный аппрув. Порог нагрузки и влияние устройства команды пока не установлены.
Что не переезжает в машину
У ревью есть функция, которую метрики очереди не видят. В исследовании Microsoft, опубликованном на ICSE 2015, лишь около 15% комментариев указывали на возможный дефект, более половины касались поддерживаемости. Ревью также помогало передавать знания и формировать общее понимание кодовой базы.
Human-AI Synergy, исследование 300 open-source проектов, обнаружило, что в агентских комментариях почти отсутствуют обсуждение контекста и обмен знаниями. Человеческие комментарии выполняют эти функции заметно чаще.
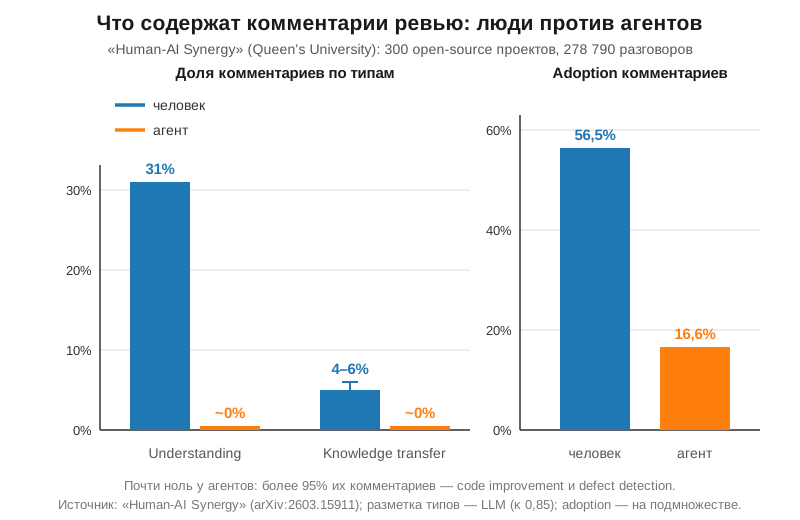
Более 95% агентских комментариев посвящены улучшению кода и поиску дефектов. Типы комментариев размечала LLM (каппа 0,85); корпус включает 300 open-source проектов, adoption измерен на его подмножестве. Источник: «Human-AI Synergy» (arXiv:2603.15911), Fig. 4. График построен по опубликованным числам.
Это разметка комментариев, а не измерение обучения. По ней нельзя заключить, что junior перестанет расти: часть знаний команда передаёт другими способами, а AI-замечания тоже могут вызывать рефлексию.
Если машинный первый круг заменяет человеческие разборы, канал передачи знаний может сужаться. Тогда важно, какую замену строит команда: ревью планов, спека-ревью, совместные обсуждения. Долгосрочного эффекта для роста junior эти исследования не показывают.
Моё мнение такое: обязательно брать в ревью OpenSpec артефакты, ADR, изменения в доменной модели, архитектурные изменения. Так мы продолжаем шарить знание на команду - но уже на уровне архитектуры и концепций.
Перестройка быстрее измерения
Измерения после мерджа уже появляются. Но они пока не позволяют отделить влияние ревью от сложности задач, возможностей агента и остальных проверок. Неясно и то, как глубина человеческой проверки меняется с нагрузкой и что происходит с передачей знаний на длинной дистанции.
Главные пробелы при этом никуда не делись: никто не связал тип автора изменения с дефектами, дошедшими до продакшна; глубина ревью не измерена как функция потока; траектории junior в командах, где первый круг делегирован машине, никто не отслеживает; порог нагрузки, за которым подпись превращается в ритуал, не найден.
Поэтому и «конец код-ревью»21, и уверенность, что человеческая подпись сохраняет прежний контроль, пока опережают доказательства. Процесс перестроили быстрее, чем научились измерять его последствия.
Для своего процесса стоит выбрать показатели ревью помимо скорости и определить, как замечать подпись без проверки. При делегировании первого круга машине нужно также решить, как сохранять передачу знаний.
В моём ревью фокус уже сместился на спецификации, архитектуру, контракты и интеграционные тесты: человеческого внимания на подробную вычитку всего потока не хватает. Насколько такой подход сохраняет качество кода и передачу знаний, я пока не могу оценить. Гайда «что обязательно ревьюить» у нас ещё нет, сейчас я им занимаюсь.
Сноски
-
Microsoft, исследование роллаута агентских CLI, препринт arXiv, 2026. +24% смёрженных PR у подключившихся. ↩
-
GitHub, Copilot code review is now generally available, changelog, 2025. ↩
-
TechCrunch, Anthropic launches Code Review tool to check flood of AI-generated code, статья, 2026. Мотивация запуска: ревью стало бутылочным горлышком. ↩
-
Where Accountability Lives, препринт arXiv, 2026. Контент-анализ 121 артефакта: различие между обязанностью проверить код и записью о её исполнении; в регулируемых средах возможны обязательные процедуры approvals. ↩
-
GitHub, Code review in the age of AI: why developers will always own the merge button, манифест, 2025. ↩
-
GitHub, документация Copilot code review, официальная документация. Опциональный зачёт ревью агента в required approvals, public preview. ↩
-
Дэниел Стенберг, curl summer of bliss, блог мейнтейнера curl, 2026. Месяц без приёма vulnerability-репортов. ↩
-
Google, AutoCommenter, препринт arXiv (AIware ’24), 2024. Развёрнут на всех разработчиков Google, 68% частых замечаний, около 40% комментариев ведут к правкам; собственный A/B значимых изменений процесса ревью не показал. ↩
-
Stripe, Minions: Stripe’s one-shot end-to-end coding agents, инженерный блог, 2026. Более тысячи агентских PR в неделю, human-reviewed, без человеческого кода. ↩
-
RevMate: полевой эксперимент LLM-ревьюера в Mozilla и Ubisoft, препринт arXiv, 2024. Приняты 8,1% и 7,2% комментариев; принятые AI-комментарии ведут к ревизиям кода так же часто, как человеческие (74% против 73%). ↩
-
Дефект-фокусированная конфигурация AI-ревьюера, ICML 2025. Поимка главных багов в два раза лучше стандартных LLM, индустриальная аффилиация. ↩
-
Крупнейшее независимое полевое исследование AI-ревью, препринт arXiv, 2025. Более 22 000 комментариев в 178 репозиториях: даже непринятые комментарии вызывают рефлексию. ↩
-
Habituation at the Gate, препринт arXiv, воркшоп KDD 2026. 400 повторных ревьюеров, 11 429 ревью за 7 месяцев на датасете AIDev: approval агентских PR растёт с 30,1% до 36,8%, инлайн-комментарии падают на 22%, время ожидания ревью растёт в 3,5 раза; данных о дефектах нет. ↩
-
Измерение acceptance и вмешательств на 567 агентских PR, препринт arXiv, 2025. 83,8% acceptance; 45% принятых агентских PR потребовали дополнительных правок. ↩
-
Veracode, 2026 GenAI Code Security Report, отчёт, 2026. Более 100 моделей: syntax pass около 100%, безопасность 56% два года подряд, лучшая модель 68%. Вендорские данные. ↩
-
Выживание AI-внесённых проблем в «диких» репозиториях, препринт arXiv, 2026. До свежих ревизий доживает 22,7% отслеженных проблем, остальные фильтруют существующие барьеры. ↩
-
Obada Kraishan, Not All Agents Are Equal, препринт arXiv, 12 сентября 2026. 37 623 PR из 2 807 репозиториев, данные декабря 2024 - июля 2025, наблюдение после мерджа 90 дней. Откаты: Codex реже людей, Devin чаще; распределение задач неслучайное. ↩
-
Michael Tran и соавторы (Google), Characterizing the Quality Profile of AI-Generated C++ in Production, препринт arXiv, 6 августа 2026. 3,52 млн изменений за апрель 2025 - апрель 2026 в одном корпоративном C++-конвейере: больше работы на ревью, меньше откатов, быстрее рост затрат ресурсов. Причинный эффект ревью не выделен. ↩
-
Honeycomb, Embracing the code review bottleneck, инженерный блог. Контрпример к дилемме: углубила ревью агентского кода, сохранив velocity. ↩
-
Queen’s University, исследование агент-вовлечённых паттернов ревью на 1,02 млн PR, препринт arXiv, 2026. Схемы с агентами ускоряют решения, но выигрыш не переводится в качество ревью (review smells); дефекты в продакшне не измерены. ↩
-
Monperrus, The End of Code Review, препринт arXiv, 2026. Позиционная статья: все цели ревью агенты закрывают дешевле и быстрее. ↩