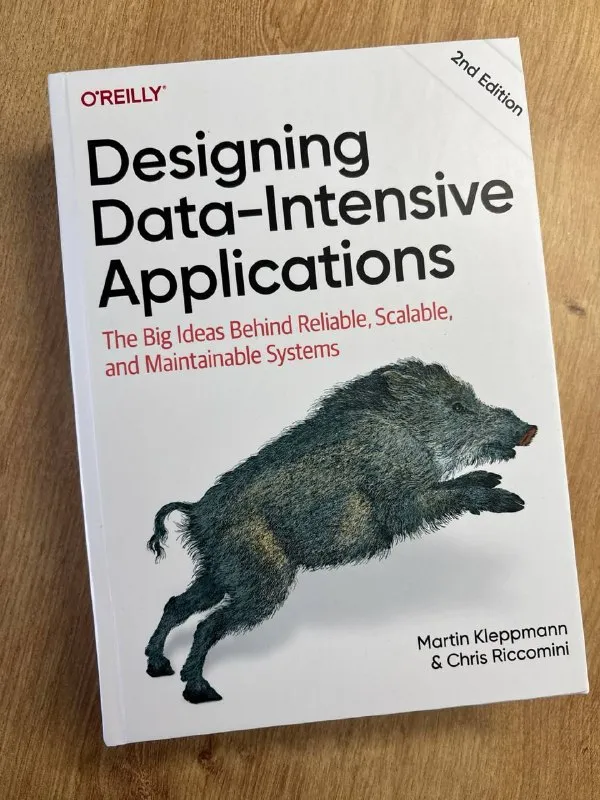
Обзор первого издания книжки с кабанчиком был одним из первых книжных обзоров на моём канале (если кому интересно, как это выглядело почти 3 года назад — вот ссылка на пост). Я эту книгу всегда любил и высоко ценил, перечитывал несколько раз, поэтому после новости о переиздании был очень рад.
Конечно, я добрался до неё не сразу, но и затягивать не стал. Мотивацию читать второго кабанчика объяснить очень просто — на мой вкус, это одна из лучших книг по system design (и точно лучшая книга по проектированию приложений с большим потоком данных).
О чём книга
Книга посвящена построению надёжных, стабильных, отказоустойчивых приложений, которые интенсивно работают с данными. Работа включает в себя чтение, запись, хранение и так далее. Также книга покрывает многие аспекты построения распределённых систем, важные для работы с данными.
В книге раскрываются следующие темы:
- как эффективно хранить и получать данные;
- как обеспечивать сохранность данных (репликация, шардирование);
- детальный разбор устройства транзакций;
- особенности работы с данными в распределённых системах;
- batch- и stream-обработка: особенности выстраивания.
Три идеи из книги
-
Сейчас на рынке появляются HTAP-базы данных (гибрид транзакционной и аналитической модели). Но часто оказывается, что «под капотом» у них всё так же две разные системы: одна для транзакционной обработки, а вторая — для аналитической. Это важно понимать при анализе конкретного решения.
-
Для многих БД непрактично останавливать весь процесс работы с целью резолва конфликта данных, поэтому они сохраняют обе версии и продолжают работать. При следующем запросе этих данных такая база возвращает обе версии клиенту, предоставляя ему самому выбрать метод решения конфликта.
-
Ошибки сети довольно редки, но приложение должно уметь справляться с ними. Особенно это важно в сложных геораспределённых системах, где сеть будет лагать и отваливаться гораздо чаще, чем в каком-нибудь небольшом кластере кубера, развёрнутом в одном ЦОДе. Этими ошибками часто пренебрегают, из-за чего вылезают неприятные баги.
Мои впечатления
Второй кабанчик стал намного лучше для меня как для читателя.
Во-первых, новая структура книги кажется мне более логичной и последовательной: читать было комфортнее, темы расположены так, чтобы не приходилось забегать вперёд (в первом кабанчике это было частой проблемой).
Во-вторых, сам контент был изрядно переписан и стал более «удобоваримым». Мне показалось, что книгу стало проще понимать (особенно в части разных весёлых аномалий). Хотя, может, это я просто стал умнее :)
DDIAv2 в моём личном рейтинге стала достойной преемницей первой части и по-прежнему будет занимать место в топе лучших технических книг, которые я когда-либо читал. Рекомендую, даже если вы читали первую часть — вас ждёт много интересных открытий и инсайтов.